Что показано
PrismML выпустили вторую версию Bonsai - модель на базе Qwen3.8 27B, пережатую в тернарные веса. Пакет с vision-башней весит 8,6 ГБ вместо условных 54 ГБ у полноразмерной версии, держит контекст 262К токенов и по паспорту сохраняет 98,2% качества оригинала. Цифру 5,9 ГБ из пресс-релиза на диске вы не увидите: это языковая модель в упаковке GGUF, а MLX-пакет вместе с vision-башней весит 8,6 ГБ. В демо её гоняют агентом в Cline на RTX 5090, но веса реально лежат в открытом доступе и запускаются на своём Mac через MLX.
Почему это работает
Обычное квантование берёт готовую модель и округляет веса до 4, 3 или 2 бит. Ниже четырёх бит качество рушится выборочно. По замерам PrismML 2-битная сборка Qwen3.8-27B (IQ2_XXS, на деле 2,8 бита на вес и 9,4 ГБ) набирает 84,1% от полной версии: на тесте знаний MMLU-Redux у неё 88,9 против 91,5, и на глаз всё в порядке, зато длинные рассуждения проваливаются (AIME 2026: 57,5 против 94,6, LiveCodeBench: 56,4 против 90,1).
Bonsai хранит каждый вес языковой модели как -1, 0 или +1, с одним общим FP16-множителем на каждые 128 весов. Перед этим матрицы поворачивают в другой базис (преобразование Адамара), а загрузчик применяет то же преобразование к активациям на лету. Выходит 1,72 бита на вес против 16 в полной версии. Как именно из весов Qwen3.8 получаются троичные значения, в анонсе, карточке и whitepaper я рецепта не нашёл: там описаны формат и замеры, но не обучение.
На замерах PrismML обычное 2-битное сжатие ломает длинные рассуждения (AIME 2026: 57,5 против 94,6 у полной версии), а Bonsai при меньшем размере держит 95,8.
Как повторить
- Проверьте, что у вас Mac на Apple Silicon (M1 и новее) - сборка под MLX работает только на нём. Нужно около 9 ГБ свободного места и минимум 16 ГБ памяти: веса весят 8,6 ГБ, так что на 8 ГБ модель не влезет. PrismML пишет, что пакет помещается в ноутбук с 16 ГБ, а один из пользователей Hacker News гоняет его на Mac mini M2 с 16 ГБ (7-8 токенов/сек). Для Windows, Linux и видеокарт NVIDIA есть GGUF-версия под llama.cpp, она в шаге 8.
- Поставьте пакет, который даёт команду
hf, в отдельное виртуальное окружение: версии вrequirements.txtмодели жёстко зафиксированы (mlx 0.32.0, mlx-vlm 0.6.3, transformers 5.5.0) и перезапишут те, что у вас уже стоят.
python3 -m venv .venv-bonsai
source .venv-bonsai/bin/activate
pip install -U huggingface_hub- Скачайте веса (реально ложится 8,6 ГБ на диск; репозиторий открытый, аккаунт на Hugging Face не нужен):
hf download prism-ml/Ternary-Bonsai-2-27B-mlx-2bit --local-dir bonsai2-27b-mlx- Поставьте рантайм-зависимости из самого пакета:
pip install -r bonsai2-27b-mlx/runtime/requirements.txt- Самая короткая проверка - скрипт из скачанной папки:
cd bonsai2-27b-mlx
python quickstart.py "Объясни в трёх предложениях, что такое тернарные веса"
Он сам подхватывает загрузчик из runtime/ и настройки сэмплера из generation_config.json. Рассуждение в нём выключено, а ответ обрезается на 256 токенах (константа MAX_TOKENS в файле). Первый запуск читает 8,6 ГБ в память, это не мгновенно.
- Если нужен свой код или картинки, вот пример из карточки модели для текста:
import sys
sys.path.insert(0, "bonsai2-27b-mlx/runtime")
from vision_artifact import load_vl_model, chat_config
from mlx_vlm import generate
from mlx_vlm.prompt_utils import apply_chat_template

model, processor, config = load_vl_model("bonsai2-27b-mlx")
prompt = apply_chat_template(processor, chat_config(config), "Ваш вопрос", num_images=0)
print(generate(model, processor, prompt, max_tokens=4096,
               temperature=1.0, top_p=0.95, top_k=20))
Для картинки поставьте num_images=1 и передайте список файлов четвёртым аргументом: generate(model, processor, prompt, ["photo.jpg"], max_tokens=4096, ...). В карточке стоит max_tokens=256, я поднял лимит: модель по умолчанию сначала рассуждает (уровень xhigh), и рассуждение съедает лимит, тогда ответ приходит пустым или оборванным на середине мысли. В списке известных проблем PrismML советует от 16384.
- Настройки сэмплера передавайте явно: mlx-vlm не читает
generation_config.json, и без аргументов генерация получится жадной. Для рассуждающего режима (он по умолчанию)temperature=1.0, top_p=0.95, top_k=20, для обычного инструктажаtemperature=0.7, top_p=0.80, top_k=20(значения прямо из README модели). - Чат в браузере, GGUF-версия, Windows и Linux - через демо-репозиторий PrismML. В карточке модели он назван главным источником по запуску: если карточка и он расходятся, прав демо-репозиторий.
git clone https://github.com/PrismML-Eng/Bonsai-demo.git
cd Bonsai-demo
BONSAI_OPENWEBUI=0 BONSAI_CODE_INTERPRETER=0 ./setup.sh
./scripts/start_llama_server.sh
Откройте http://localhost:8080 - там чат с картинками и инструментами. setup.sh ставит форк llama.cpp от PrismML (обычный llama.cpp эти файлы не откроет) и качает GGUF в упаковке PQ2_0, 7,8 ГБ вместе с vision-проектором. Без двух переменных в начале он ещё ставит Open WebUI и интерпретатор кода, это лишние несколько ГБ. Один вопрос из терминала без сервера: ./scripts/run_llama.sh -p "Ваш вопрос". На Windows скрипты называются setup.ps1 и scripts\start_llama_server.ps1. На Mac тот же setup.sh заводит и MLX-окружение (там mlx-vlm 0.7.2, а не 0.6.3 из карточки), сервер на нём поднимается через ./scripts/start_mlx_server.sh. Эти команды я сверил с README демо-репозитория, но не запускал.
Ссылки и ресурсы
- Анонс PrismML - первоисточник статьи от 17 сентября 2026: таблица тестов, скорость, ссылки на whitepaper и видео; это реклама собственного продукта; бесплатно.
- Карточка модели MLX - веса 8,6 ГБ, Apache 2.0, команды запуска,
quickstart.pyи папкаruntime/с загрузчиком; репозиторий открытый, вход в аккаунт не нужен; бесплатно. - GGUF-версия - для CUDA, Metal и CPU: PQ2_0 (7,2 ГБ) и PTQ1_0 (5,95 ГБ) плюс vision-проектор; запускается только на форке llama.cpp от PrismML; бесплатно.
- Известные проблемы - список от PrismML, проверен 23 сентября: пустые ответы из-за малого лимита токенов, ошибка 500 при
reasoning_effort: "high", падение на процессорах с AVX-512; читайте до того, как решите, что не работает. - Bonsai-demo - демо-репозиторий с
setup.shиsetup.ps1, серверами и Open WebUI; PrismML называет его главным источником по запуску; бесплатно. - Форк llama.cpp от PrismML - нужен для GGUF-файлов, бинарники ставит
setup.sh; бесплатно. - Замеры сообщества - таблица скорости на реальном железе: M3 Max 36 ГБ около 24 токенов/сек, M4 Pro 64 ГБ около 20 (llama.cpp) и 19 (MLX), плюс видеокарты; бесплатно.
- Whitepaper (PDF) - методика замеров и полные таблицы; именно здесь Terminal-Bench 2.1 (52,8 против 69,7) и SWE-bench Verified (60,8 против 80,6), которых в анонсе нет; бесплатно.
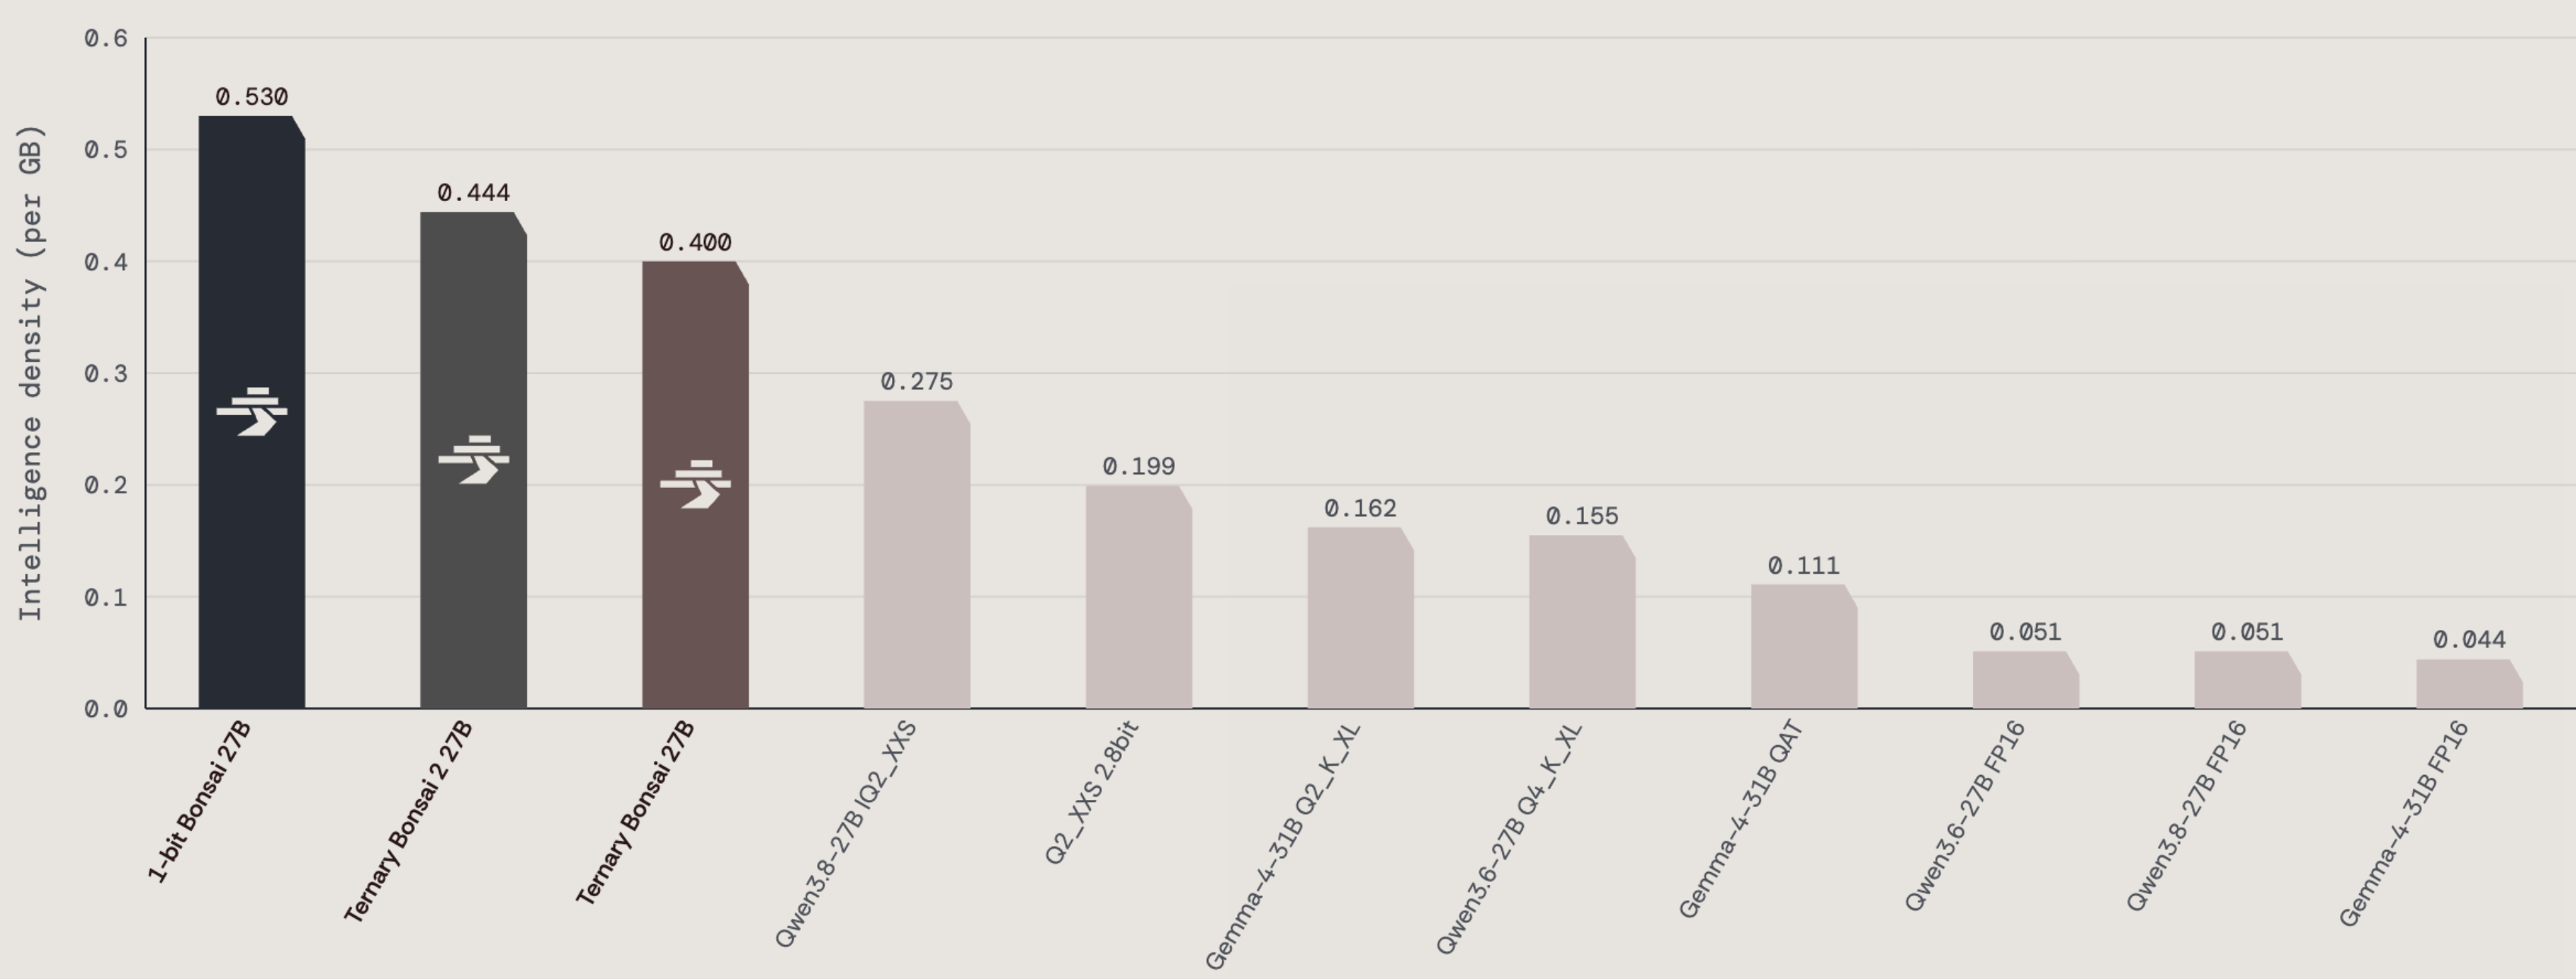
- График плотности интеллекта - картинка из анонса, «интеллект на гигабайт»: у Ternary Bonsai 2 27B 0,444, у Qwen3.8-27B в FP16 0,051; метрика придумана PrismML, в карточке модели те же величины посчитаны иначе (0,469 и 0,053); открывается, бесплатно.
- Видео: Ternary Bonsai 2 27B с Cline на RTX 5090 - демо кодового агента на видеокарте, а не на Mac; страница открывается, само видео я не смотрел; бесплатно.
- Cline - кодовый агент (расширение VS Code, приложение, CLI), который работает с локальными моделями через Ollama, LM Studio или любой OpenAI-совместимый адрес; расширение бесплатное и с открытым кодом (Apache 2.0), платите только за подключённую модель, платные тарифы у Cline тоже есть, их не смотрел; для этой статьи нужен только чтобы повторить демо.
- Обсуждение на Hacker News - отчёты пользователей: Mac mini M2 16 ГБ 7-8 токенов/сек, M4 Pro 24 ГБ около 15, зацикливание в браузерной версии, провал на реальных агентских задачах; это мнения, а не замеры; бесплатно.
- Блог OrcaRouter: что значит 98,2% - разбор с теми же цифрами; сайт - коммерческий API-роутер, а числа в разборе взяты из материалов самой PrismML, так что независимой проверкой он не служит; бесплатно.
- Qwen3.8-27B - исходная модель для сравнения, около 54 ГБ в FP16; открывается.
- Команда hf в документации Hugging Face - если
hf downloadне находится или просит войти; бесплатно.
Проверочный прогон
Скрипт должен выдать связный ответ за разумное время. По замерам PrismML это около 47 токенов/сек на M5 Max и 28 на M5 Pro (через llama.cpp; цифра для M5 Max снята на более ранней сборке и ждёт перемера), у пользователей на M3 Max около 24, на M4 Pro 15-20, на Mac mini M2 с 16 ГБ 7-8. На M4 Pro первый ответ на длинный запрос упирается уже в обработку промпта (около 100-125 токенов/сек). Если скорость в разы ниже, проверьте, не включён ли в macOS режим низкого энергопотребления: PrismML пишет, что он сильно душит вывод.
Если команда hf не находится - huggingface_hub не установился или не попал в PATH. Если падает на импорте vision_artifact - не туда указан sys.path или пропущен шаг с pip install -r. Если ответ пустой или обрывается на середине мысли - модель рассуждала и упёрлась в max_tokens, поднимите лимит. Если ответ идёт по токену в минуту и вентилятор воет - модель не влезла в оперативку и ушла в своп: закройте тяжёлые приложения, уменьшите контекст или запустите GGUF-вариант через демо-репозиторий. Он легче (7,8 ГБ вместе с vision-проектором против 8,6 ГБ), а длину контекста там задаёт переменная BONSAI_CTX. Веса у него те же троичные, просто упакованы иначе, никакого более грубого кванта.
Где это пригодится
Если у вас Mac и хочется погонять модель уровня 27B без подписки на облачный API и без счётчика токенов - это первый кандидат: лицензия Apache 2.0, после скачивания работает без интернета. Как резерв для коротких задач (разбор скриншота, черновик кода, суммаризация) подойдёт. Для длинного агентского цикла, вроде многошаговой работы с терминалом или почтой, закладывайте запас на просадку: сама PrismML в whitepaper показывает там не 98%, а около трёх четвертей от полной модели, а пользователи на Hacker News пишут, что на ноутбуке простая агентская задача занимала 25 минут или не решалась вовсе. Сам запуск на Mac я не проверял: команды сверены с карточкой модели и README демо-репозитория.
Оговорки
- 98,2% - цифра PrismML на собственном наборе тестов, независимой проверки нет. В анонсе и whitepaper это 20 тестов (83,9 против 85,4), в карточке модели 14 (84,78 против 86,32), и оба раза выходит 98,2%. Просадка неравномерна: по набору из анонса знания и рассуждения теряют 2,7 балла, зрение 3, а по набору из карточки 5,7 и 5,2. На длинных агентских задачах разрыв самый большой: Terminal-Bench 2.1 52,8 против 69,7 и SWE-bench Verified 60,8 против 80,6, около трёх четвертей от полной модели. Эти цифры PrismML сама приводит в whitepaper, блог OrcaRouter только пересказывает их.
- Вес пакета для Mac - 8,6 ГБ (7,67 ГБ языковая модель плюс 0,92 ГБ vision-башня), а не 5,9 ГБ из пресс-релиза. Причина известна из карточки: MLX хранит для каждой группы весов и множитель, и смещение (2,25 бита на вес против 1,75 в GGUF PTQ1_0), плюс vision-башня лежит в FP16. Цифра 5,9 ГБ - это языковая модель в GGUF.
- Обычные MLX-загрузчики модель не откроют: она объявлена как
prism_hadamard_qwen35, и без загрузчика изruntime/пакет либо не загрузится, либо, по словам PrismML, даст неверный текст без ошибки. Простой вызов есть:quickstart.pyв пакете, а чат в браузере ставится через демо-репозиторий. - Модель по умолчанию рассуждает на уровне
xhigh. Уровеньlowне поддерживается и работает почти какxhigh, короче отвечаетmedium. Короткийmax_tokensдаёт пустой или оборванный ответ. - GGUF-версия (CUDA, Metal, CPU) запускается только на форке llama.cpp от PrismML: обычный llama.cpp эти файлы не откроет. Форк ставит
setup.sh. Этот путь я не запускал. - Пользователи на Hacker News пишут про зацикливание в браузерной версии и провал на длинных агентских задачах. Это отдельные отзывы, а не замеры, но они совпадают с цифрами PrismML про Terminal-Bench.
- Источник - блог самой PrismML, независимых голосов в исходном посте не было, их пришлось искать отдельно. Компания при этом предлагает платную доработку моделей под заказчика (раздел «Work with Us» в анонсе), цена не указана; сами веса бесплатные.